Raft Algoritması ve Kafka’ya Kattığı Güç
Dağıtık sistemlerin en zor problemlerinden biri, farklı düğümler arasında consensus sağlamaktır. Yani her node’un aynı “gerçeği” kabul etmesi gerekir. Bu yalnızca akademik bir problem değil; finansal…
Dağıtık sistemlerin en zor problemlerinden biri, farklı düğümler arasında consensus sağlamaktır. Yani her node’un aynı “gerçeği” kabul etmesi gerekir. Bu yalnızca akademik bir problem değil; finansal işlemlerden sosyal medya akışına, uçak bileti rezervasyonlarından IoT sensör ağlarına kadar hayatın her alanında kritik öneme sahiptir.
Uzun yıllar bu problem, Paxos gibi güçlü ama karmaşık algoritmalarla çözülmeye çalışıldı. Ancak Paxos’un anlaşılması ve uygulanması zordu. İşte bu noktada Raft devreye girdi: Daha anlaşılır, daha uygulanabilir ve aynı derecede güçlü bir consensus algoritması.
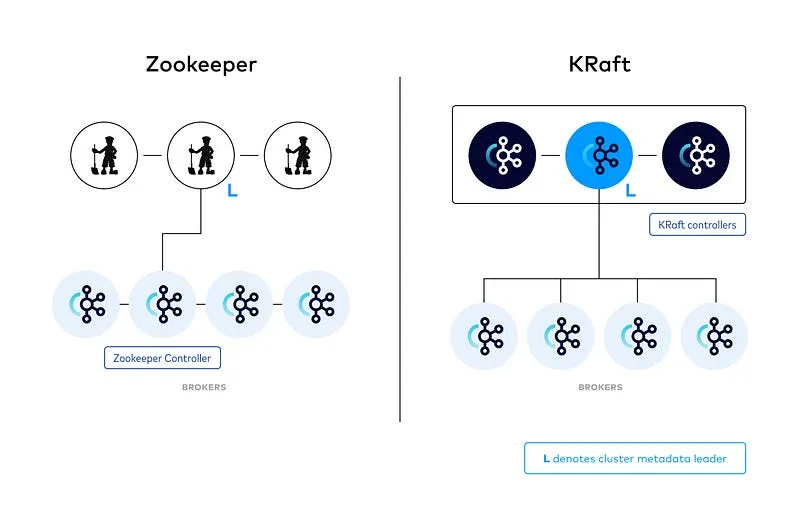
Raft algoritmasının kullanılmasıyla geliştirilmiş olan KRaft teknolojine geçmeden önce Zookeeper ile sürecin nasıl yürütüldüğünü hatırlamak gelişimin ne kadar da önemli olduğunu daha net hatırlamamıza yardımcı olacaktır.
Kafka’nın ZooKeeper Dönemi
Kafka’nın ilk yıllarında metadata yönetimi için ZooKeeper kullanılıyordu. ZooKeeper, Kafka cluster’ının beyni’ydi. Zookeeper üzerinden tutulan bilgiler:
- Broker’ların durumu,
- Topic ve partition bilgileri,
- Hangi broker’ın hangi partition’da lider olduğu,
- ACL ve konfigurasyon bilgileri
Bu yaklaşımın sorunları:
- Operasyonel karmaşıklık → Kafka yanında ZooKeeper da kurmak, izlemek, upgrade etmek gerekiyordu.
- Consistency problemleri → Network partition durumlarında ZooKeeper ile Kafka arasında uyumsuzluk çıkabiliyordu.
- Scaling zorlukları → Büyük cluster’larda ZooKeeper yükü artıyor, recovery süreçleri uzuyordu.
- Teknoloji uyumsuzluğu → ZooKeeper’ın quorum protokolü (ZAB), Kafka’nın iş yüküne özel değildi.
Kısacası Kafka, çok kritik metadata bilgisini başka bir sisteme emanet ediyordu. Bu bağımlılık hem operasyonel risk hem de performans dezavantajı yaratıyordu. İşte bu gibi sorunların sonucunda çok güçlü bir consensus algoritması olan Raft alt yapısıyla KRaft oluşturuldu. Kraft tarafına geçmeden önce bir de Raft’ı inceleyelim.
Raft Algoritmasının Temelleri
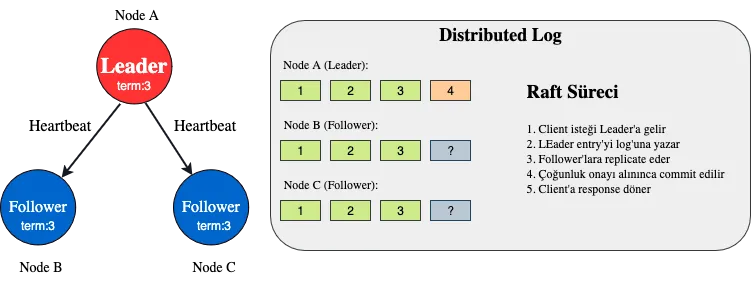
Raft Consensus Algoritması
Raft’ın güzelliği, karmaşık consensus problemini basit parçalara ayırarak çözmesinde yatıyor. Algoritmanın tasarım felsefesi “anlaşılır olmak” (understandability). Yani Paxos gibi sadece akademik çevrelerde anlaşılabilen değil, gerçek hayatta sistem mühendislerinin de rahatlıkla okuyup uygulayabileceği bir model sunmak.
Raft’ı anlamak için üç temel kavrama odaklanmak yeterlidir: Leader Election, Log Replication ve Safety. Bu üç mekanizma birleşerek cluster’ın hem tutarlı hem de yüksek erişilebilir olmasını sağlar.
Leader Election
Raft’ta her zaman tek bir leader vardır.
- Follower’lar leader’dan gelen heartbeat mesajlarını dinler.
- Eğer heartbeat kaybolursa follower, candidate olur ve çoğunluk oyu almak için seçim başlatır.
- Çoğunluğu alan candidate, yeni leader olur.
Log Replication
- Leader gelen her yazma isteğini kendi log’una ekler.
- Bu log entry, follower’lara çoğaltılır (AppendEntries).
- Çoğunluk onay verdikten sonra entry commit edilir.
- Commit edilen entry state machine’e yansıtılır.
Safety
- Yalnızca quorum tarafından commit edilen log’lar geçerli olur.
- Yeni seçilen lider, en güncel log’a sahip olmalıdır.
- Commit edilmemiş log’lar gerekirse geri alınır.
Raft algoritmasının nasıl çalıştığını gördük: tek bir leader, tutarlı bir log ve quorum temelli karar alma. Peki bu teorik model Kafka için ne ifade ediyor? İşte burada sahneye KRaft çıkıyor. Kafka topluluğu, Raft’ın prensiplerini alıp kendi dünyasına uyarladı ve yıllardır beraber yaşamak zorunda kaldığı ZooKeeper’a veda etmeye başladı.
KRaft: Kafka’nın Yeni Dönemi
Kısaca söylemek gerekirse KRaft, Raft’ın Kafka’ya özel yorumlanmış hali. Ama sadece algoritmayı alıp kopyalamak değil; Kafka’nın metadata yönetimi için sıfırdan tasarlanmış, ZooKeeper’ın bıraktığı boşlukları dolduran bir mimari. 2.8.0 versiyonu ile başlayan geçiş dönemi 4.0 versiyonu ile resmen tamamlanmış oldu. Artık metadata yönetim modu sadece KRaft oldu.
Nasıl Çalışıyor?
- Kafka’da artık bir controller quorum var (genellikle 3 veya 5 node).
- Bu quorum içinden bir controller-leader seçiliyor.
- Tüm metadata değişiklikleri (topic yaratma, partition leader ataması, ACL güncellemesi) bu leader üzerinden yapılıyor.
- Değişiklikler quorum’un çoğunluğu tarafından commit edilmeden geçerli olmuyor.
Kafka’ya Kazandırdıkları
- ZooKeeper bağımlılığı yok → Tek sistem, daha az operasyonel yük.
- Strong consistency → Metadata quorum commit olmadan geçerli değil.
- Deterministic failover → Controller-leader düştüğünde hızlı ve öngörülebilir şekilde yenisi seçiliyor.
- Basitlik → Raft’ın “understandability” avantajı Kafka’ya taşındı.
- Daha az risk → Split-brain ve metadata uyumsuzluğu sorunları büyük ölçüde ortadan kalktı.
Sonuç
Raft algoritması, consensus problemini hem anlaşılır hem de güçlü bir şekilde çözdü. Kafka ise bu prensipleri alarak ZooKeeper bağımlılığını ortadan kaldırdı ve KRaft mimarisini geliştirdi.
Özet:
- ZooKeeper dönemi → Karmaşıklık ve bağımlılık.
- Raft prensipleri → Anlaşılır consensus modeli.
- KRaft dönemi → ZooKeeper’sız, quorum tabanlı, self-contained Kafka cluster.
Kafka artık yalnızca bir messaging sistemi değil, kendi metadata consensus’unu yöneten güçlü bir dağıtık platform.
Dipnot: ZooKeeper’dan KRaft’a geçiş “doğrudan” olmadı. Bu dönüşümün yol haritası KIP-500 (Kafka Improvement Proposal 500) ile tanımlandı. KIP-500, ZooKeeper’ı kaldırıp Kafka içinde Raft tabanlı metadata quorum yönetimini mümkün kılmak için önerildi ve kabul edildi. Bugün gördüğümüz KRaft mode, bu yolculuğun sonucu.